Panduan langkah demi langkah untuk menyiapkan dan mengintegrasikan Grav CMS menggunakan docker-lamp-grav di VPS Linux, macOS, dan Windows.
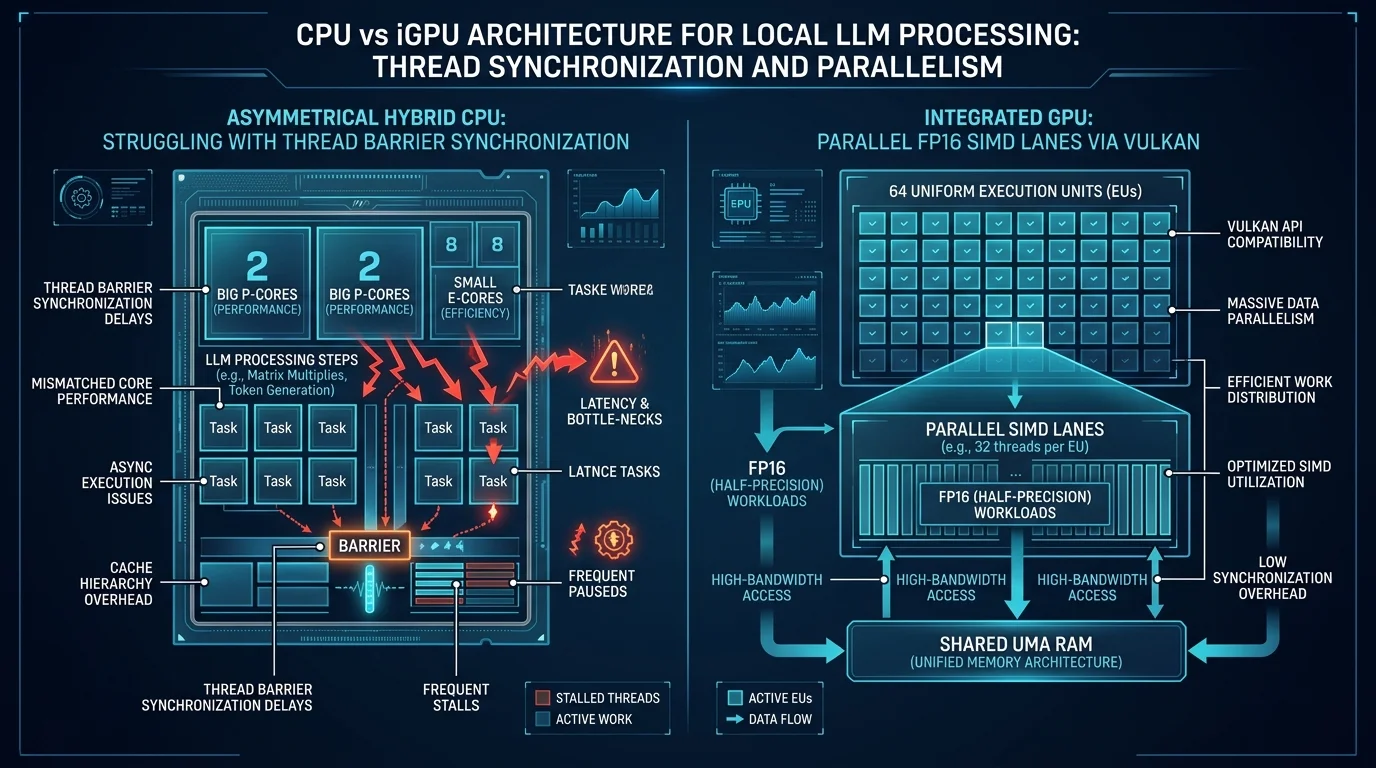
Kalau kamu sering nongkrong di Reddit, forum dev, atau grup Discord AI lokal, pasti sudah hafal luar kepala dengan dogma keramat ini: "Kalau laptopmu tidak punya GPU diskret NVIDIA, jangan coba-coba nyalakan GPU offload! Grafis terintegrasi (iGPU) itu tidak punya VRAM, memorinya nebeng RAM utama, malah bikin lambat. Mending pasrah pakai CPU AVX2 saja!" Bahkan asisten AI pun dengan percaya dirinya mengulang teori buku teks ini: menghitung batas bandwidth memori, menunjuk 64 Execution Unit yang imut-imut, lalu dengan sopan menyuruh Intel UHD Graphics kamu duduk tenang di pojokan. Cuma ada satu masalah: begitu kita uji coba langsung di hardware beneran, iGPU-nya ternyata terbukti lebih cepat dan konsisten dibanding CPU murni.
Selama tiga tahun terakhir, pemanfaatan kecerdasan buatan dalam pengembangan perangkat lunak telah mengalami revolusi struktural besar. Kita telah melompat dari sekadar pelengkap kode satu baris (autocomplete) ke chatbot interaktif, dan kini memasuki era sistem rekayasa perangkat lunak agentic otonom. Coding agent modern memiliki kemampuan menjalankan perintah terminal, mengaudit log sistem, mendiagnosis crash kernel, memanggil subagent khusus, hingga mengelola staging server produksi. Namun, banyak tim insinyur frustrasi saat bekerja dengan coding agent: agen kerap melenceng dari instruksi, mengambil jalan pintas arsitektur yang ceroboh, menimpa file kerja secara diam-diam, atau berhalusinasi menggunakan pustaka fiktif. Kunci utama untuk membuka potensi penuh lingkungan otonom seperti Google Antigravity adalah dengan menerapkan Mental Model Anak Magang Jenius Tanpa Arah (Directionless Genius Intern) serta membangun tata kelola workspace yang disiplin.
Sistem Enterprise Resource Planning (ERP) merupakan sistem saraf operasional sebuah bisnis modern. Namun, sebagian besar perusahaan di Indonesia saat ini terjebak dalam krisis langganan SaaS cloud yang terus membengkak: aplikasi yang terfragmentasi dan terpisah-pisah, ketergantungan pada vendor pihak ketiga (vendor lock-in), kerentanan kedaulatan data, serta integrasi rapuh yang lumpuh saat jaringan internet terputus. Dalam artikel arsitektur mendalam ini, kami mengulas bagaimana MilkTechERP dirancang sebagai platform sistem operasi bisnis yang mandiri, berdaulat, dan siap beroperasi di jaringan tertutup (air-gapped)—mengintegrasikan isolasi tingkat schema PostgreSQL, kepatuhan hukum perpajakan Indonesia 100% (PPh 21 TER, BPJS, e-Faktur 4.0), jaringan mesh terenkripsi tanpa port publik terbuka, serta buku besar audit WORM Merkle yang tidak dapat diubah (immutable).
Saat memilih komputer untuk menjalankan AI generator gambar secara lokal, faktor penentu utama adalah biaya, memori RAM vs VRAM, bandwidth memori, dan kecepatan render. Bagaimana performa laptop Intel Core i3-1220P CPU dengan 8GB RAM jika dibandingkan dengan kartu grafis dedicated seperti RTX 3060 atau RTX 4090? Dalam benchmark komparatif ini, kami menguji 5 tingkatan spesifikasi hardware untuk melihat kecepatan waktu render dunia nyata, batas konsumsi memori, dan rekomendasi pengaturan untuk tiap kelas.
Apakah mungkin menjalankan AI generator gambar lokal di laptop standar dengan prosesor Intel i3 dan RAM 8GB saja? Jawabannya adalah bisa. Meskipun framework Python populer seperti AUTOMATIC1111 atau ComfyUI akan mengalami kehabisan memori (OOM) pada RAM 8GB, mesin inferensi berbasis C++ seperti stable-diffusion.cpp memungkinkan Anda menghasilkan gambar berkualitas langsung dari CPU. Berikut adalah panduan praktis untuk mengonfigurasi dan mengoptimalkan Stable Diffusion di laptop dengan CPU Intel Core i3-1220P (10 core: 2 P-core + 8 E-core) dan RAM 8GB.
Ingin memahami bagaimana Stable Diffusion dapat menghasilkan gambar berkualitas tinggi hanya dari petunjuk teks sederhana, dan perangkat keras apa yang sebenarnya Anda butuhkan? Berbeda dengan layanan tertutup seperti Midjourney atau DALL-E, Stable Diffusion bersifat open-weight. Artinya, siapa saja dapat mengunduh model ini, menjalankannya di komputer pribadi secara gratis, atau menginstalnya di server sendiri. Dalam panduan ini, kita akan membahas cara kerja Latent Diffusion, membandingkan berbagai versi model, melihat kebutuhan spesifikasi hardware, serta mengenal ekosistem AI yang ada saat ini.
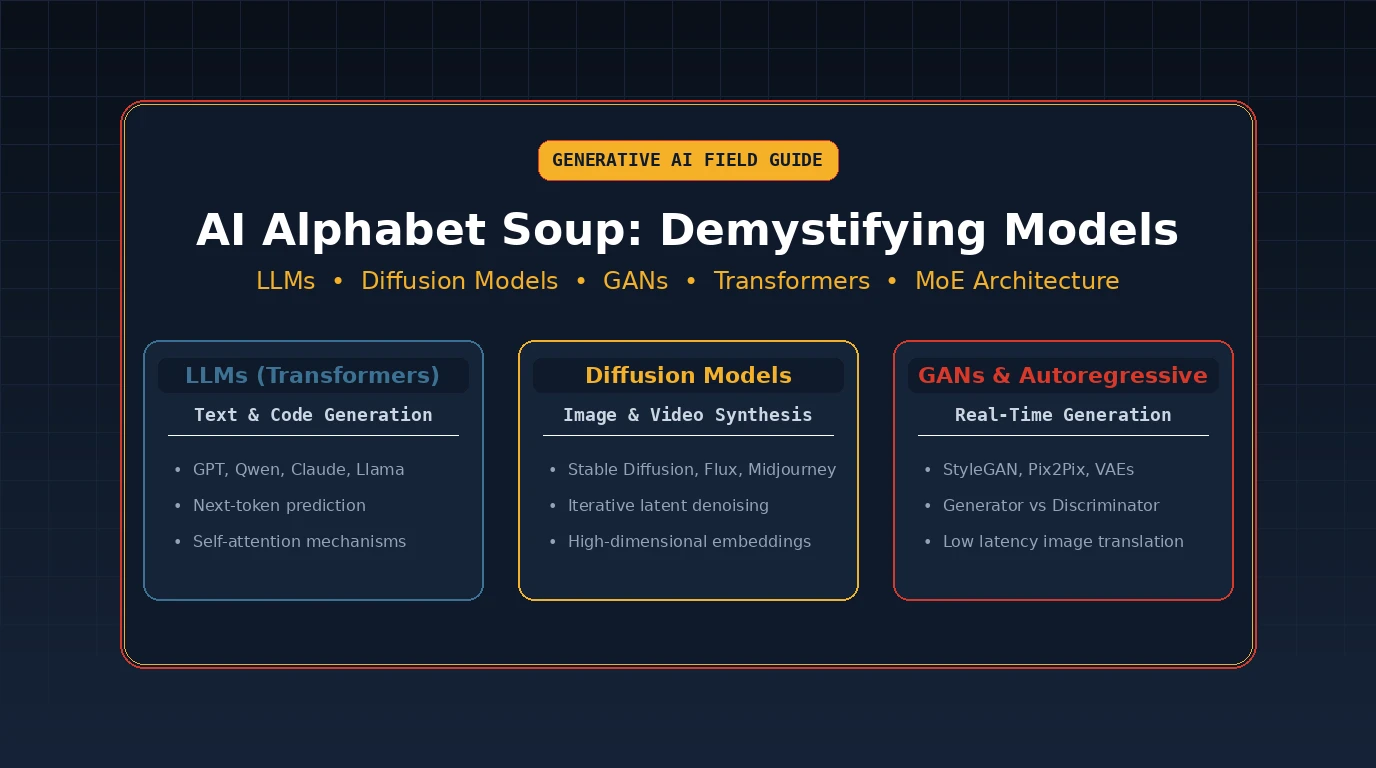
"AI" dipakai sebagai satu kata sapu-jagat, mirip menyebut semua kendaraan di jalan sebagai "mobil". Ayo kita atur lalu lintasnya. Pertama, Tiga Ember Besar Hampir semua yang dimaksud orang dengan "AI" masuk ke salah satu dari tiga kategori bersarang, bukan semesta terpisah, hanya lingkaran...
Dalam Bagian IV dari seri ini, kami melakukan benchmark terhadap latensi LAN lokal dan mesh Tailscale untuk grav-ai-chatbot, membuktikan bahwa transport jaringan sangat cepat dan andal. Namun, segera setelah model pemrosesan logika seperti qwen3.5:2b di-deploy ke produksi, pengguna mulai...
Pengujian Kinerja Ollama Melalui Tailscale & LAN: Mengejar Latensi di Bawah Detik untuk Chatbot Grav AI Di Bagian III, kami membangun pipeline 5 tingkat untuk grav-ai-chatbot — mesin pencari AI lokal yang berjalan di laptop Intel Celeron 6-Watt. Begitu chatbot itu mulai menerima lalu li...