Kalau kamu sering nongkrong di Reddit, forum dev, atau grup Discord AI lokal, pasti sudah hafal luar kepala dengan dogma keramat ini: "Kalau laptopmu tidak punya GPU diskret NVIDIA, jangan coba-coba nyalakan GPU offload! Grafis terintegrasi (iGPU) itu tidak punya VRAM, memorinya nebeng RAM utama, malah bikin lambat. Mending pasrah pakai CPU AVX2 saja!"
Bahkan asisten AI pun dengan percaya dirinya mengulang teori buku teks ini: menghitung batas bandwidth memori, menunjuk 64 Execution Unit yang imut-imut, lalu dengan sopan menyuruh Intel UHD Graphics kamu duduk tenang di pojokan.
Cuma ada satu masalah: begitu kita uji coba langsung di hardware beneran, iGPU-nya ternyata terbukti lebih cepat dan konsisten dibanding CPU murni.
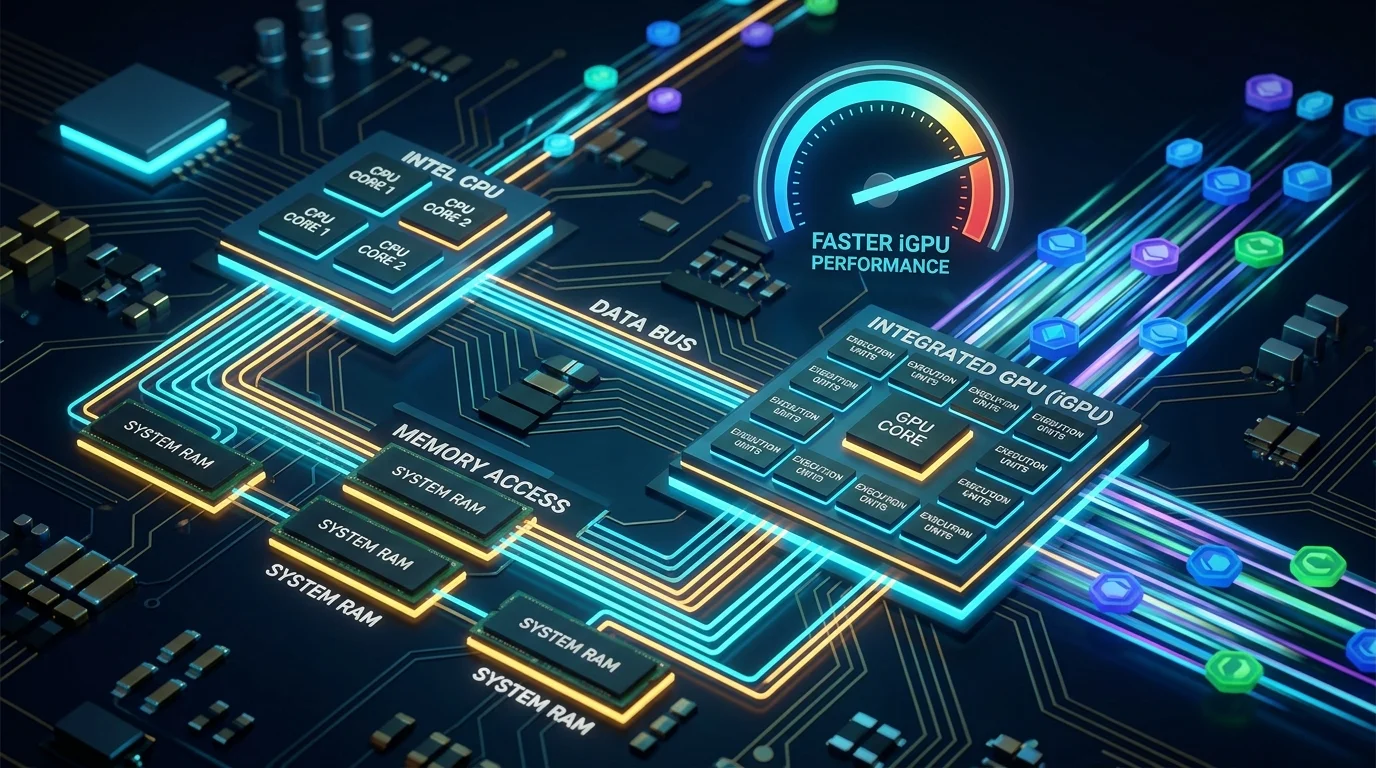
Di laptop sederhana bertenaga Intel Core i3-1220P Gen 12 yang menjalankan Linux Mint, offload penuh ke iGPU mengungguli CPU sebesar +25% pada MiniCPM-2B dan +45% pada Gemma-4-E4B.
Peningkatannya memang bukan 10x lipat seperti melompat ke GPU gaming RTX 4090, tapi kenaikan 25% hingga 45% adalah pembeda nyata antara streaming respons yang tersendat-sendat dengan teks yang mengalir nyaman mengikuti kecepatan membaca.
Lantas, kenapa teori buku teks bisa meleset? Dan bagaimana caramu menjalankan pengujian A/B sederhana ini di laptopmu sendiri?
Dari Celeron N4100 ke Core i3 Modern: Asumsi yang Terbawa
Pada eksperimen sebelumnya (Bagian 1: Menjalankan AI Lokal di Celeron N4100 dan Bagian 2: Self-Hosting Server Ollama Headless), kita memeras kemampuan laptop Celeron 6-Watt hingga batas maksimal. Di mesin lawas tersebut, kita memang tidak punya pilihan selain pasrah memakai CPU murni: grafis Intel Gen9 saat itu belum memiliki backend komputasi yang mumpuni, dan kita harus mengandalkan model mungil 0.5B serta trik prompt caching agar responsnya tidak lambat.
Begitu berpindah ke laptop Intel Core i3 Gen 12, asumsi spontan kita tentu: "Ah, ini kan masih sama-sama grafis terintegrasi yang nebeng RAM sistem, pasti aturannya tetap sama: mending pakai CPU saja."
Asumsi tersebut diperkuat oleh teori standar yang sering dibahas di komunitas.
Teori Buku Teks (Dan Kenapa Dulu Semua Orang Percaya)
Biar adil, kita harus paham dulu kenapa komunitas sempat memegang erat asumsi ini.
Proses pembuatan token pada LLM (kata demi kata yang muncul berurutan) pada dasarnya adalah beban kerja yang terbatas oleh bandwidth memori (memory-bandwidth bound). Tiap kali memprediksi satu token baru, prosesor harus membaca seluruh bobot (weights) miliaran parameter dari RAM.
Logika di atas kertasnya kelihatan sangat masuk akal:
- GPU diskret (seperti RTX 4070) punya memori GDDR6 khusus dengan kecepatan tinggi: 504 GB/s.
- Laptop harian kita hanya punya RAM sistem dual-channel dengan kecepatan sekitar ~50 GB/s.
- Karena iGPU memakai jalur memori yang sama persis dengan CPU, melempar kerjaan ke iGPU secara teori memberikan tambahan bandwidth nol.
Ditambah lagi ingatan masa lalu tentang driver OpenCL yang ringkih serta runtime Intel oneAPI/SYCL yang ukurannya bergiga-giga tapi sering crash, kesimpulan orang-orang jadi seragam: Pakai CPU saja biar aman.
Fakta Lapangan: Angka Hasil Pengujian
Pada tanggal 12 Oktober 2026, kami melakukan pengujian A/B sederhana menggunakan llama.cpp (build b11564) yang dikompilasi dengan backend Vulkan di atas Intel Core i3-1220P (Alder Lake GT2, 64 EU, driver Mesa 25.2.8, RAM 16 GB).
Dua model terkuantisasi modern diuji:
- MiniCPM5-2B (Q4_K_M): ukuran bobot ~1.45 GB.
- Gemma-4-E4B (UD-Q4_K_XL): ukuran bobot ~4.76 GB.
Ini dia hasil perbandingannya:
| Model | CPU Murni (-ngl 0) |
iGPU Penuh (-ngl 99) |
Peningkatan | Kestabilan iGPU (StdDev) |
|---|---|---|---|---|
| MiniCPM5-2B | 11.55 t/s | 14.46 t/s | +25.2% | ±0.02 t/s |
| Gemma-4-E4B | 5.10 t/s | 7.38 t/s | +44.7% | ±0.01 t/s |
Bukan cuma iGPU lebih cepat di pemrosesan prompt (pp) dan kecepatan generasi token (tg), tapi jalannya juga sangat konsisten. Kalau di CPU fluktuasi kecepatannya berkisar di ±0.44 t/s, di iGPU angkanya stabil di deviasi ±0.01 t/s.
Kenapa Teori Lama Runtuh?
Teori klasik di buku teks melewatkan dua hal mendasar: API grafis modern dan arsitektur CPU jaman sekarang.
1. Ilusi "Bandwidth Memori Pasti Mentok"
Teori lama berasumsi kalau kecepatan eksekusi akan langsung mentok di batas fisik RAM. Namun kenyataannya: kamu hanya bisa mentok di bandwidth RAM kalau prosesormu cukup kencang untuk memompa data sebesar itu.
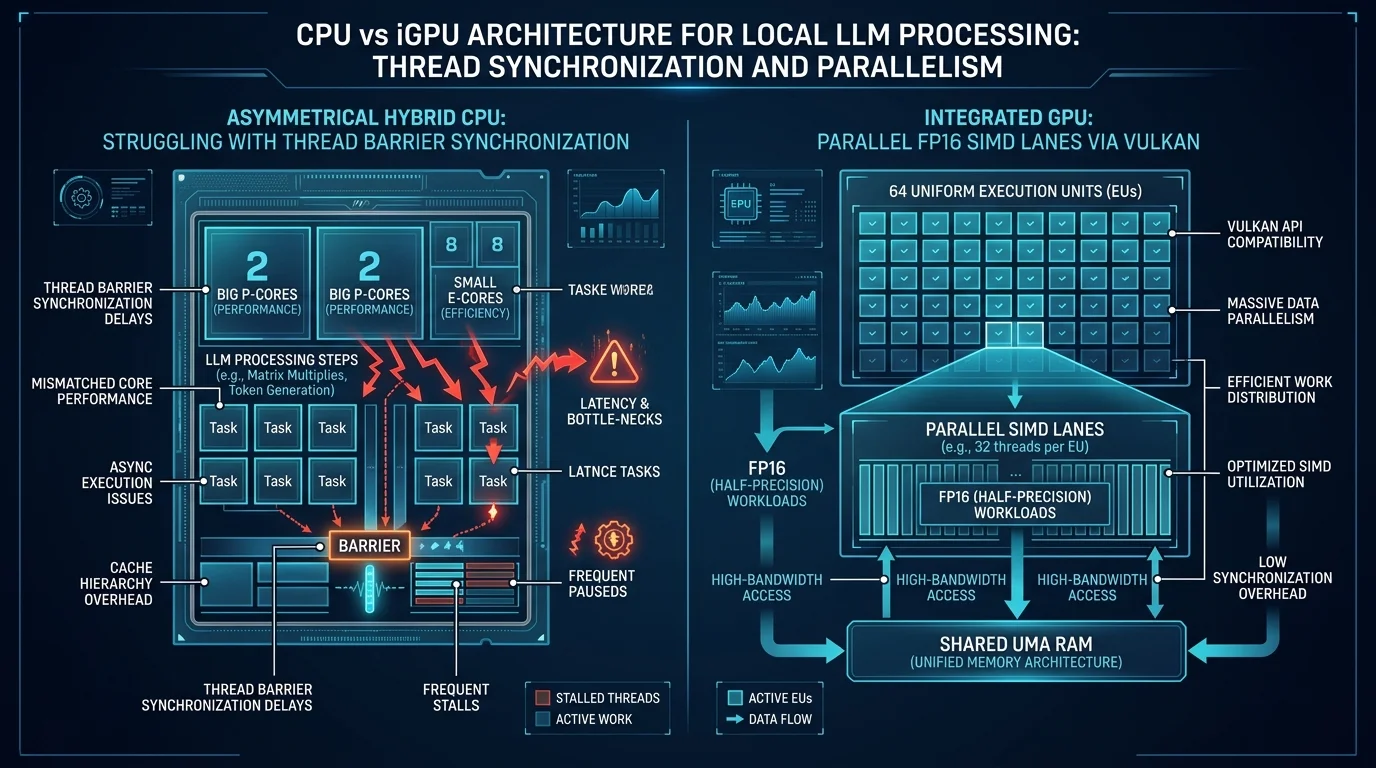
Jika CPU tersendat oleh jeda sinkronisasi antar thread dan beban komputasi dekuantisasi tiap token, CPU tidak akan mampu meminta data cukup cepat untuk membuat bus RAM kewalahan.
Kecepatan generasi iGPU yang lebih tinggi (7.38 t/s vs 5.10 t/s pada Gemma, serta 14.46 t/s vs 11.55 t/s pada MiniCPM) membuktikan bahwa unit komputasi GPU mengolah kalkulasi tiap token dengan lebih efisien, menjaga aliran data tetap berjalan lebih lancar dibanding susunan inti CPU hybrid.
2. Faktor Arsitektur CPU Hybrid (Inti Asimetris vs. GPU Seragam)
Faktor arsitektur yang sangat mungkin berkontribusi terhadap throughput CPU yang lebih rendah adalah desain inti hybrid Intel. Chip Core i3-1220P memadukan 2 Performance (P) Core berkecepatan tinggi dengan 8 Efficient (E) Core yang lebih kecil.
Pada engine perkalian matriks multithreaded seperti llama.cpp:
- Beban komputasi dibagi secara statis ke beberapa thread pekerja, yang secara berkala melakukan sinkronisasi pada execution barrier.
- Ketika thread berjalan di atas inti dengan clockspeed dan IPC yang tidak seimbang, inti yang lebih cepat bisa tertahan menunggu inti yang lebih lambat menyelesaikan bagian perhitungannya.
- Karakteristik asimetris ini membuat penyesuaian jumlah thread pada chip hybrid cukup menantang (alasan kenapa pengujian kami menggunakan 8 thread dan bukan memaksakan seluruh 12 thread).
Sebaliknya, 64 Execution Unit (EU) pada iGPU bersifat sepenuhnya seragam. Setiap unit memproses instruksi SIMD paralel dengan ritme yang konsisten tanpa kendala ketimpangan antar inti.
3. Dukungan Vulkan Modern & Native FP16
Saat ini, engine llama.cpp sudah memiliki backend Vulkan (ggml-vulkan) yang sangat matang. Bersama driver Mesa anv bawaan Linux:
- Zero-Copy UMA: iGPU memetakan memori RAM sistem secara langsung tanpa perlu proses penyalinan data bolak-balik.
- Shader Native FP16: Grafis Intel Gen12 mendukung
VK_KHR_shader_float16_int8. Operasi dekuantisasi 4-bit ke FP16 diproses dua kali lebih cepat dibandingkan kalkulasi float biasa.
Kenapa Pandangan Lama Berbeda (Dan Bagaimana Perbandingannya dengan CPU Lain)
Secara historis, saran seputar LLM lokal menyebutkan bahwa offload ke iGPU dengan memori bersama (UMA) hanya membantu pemrosesan prompt (pp) dan tidak berdampak apa-apa, atau bahkan memperlambat, generasi token (tg), karena CPU dan iGPU sama-sama berbagi bandwidth RAM sistem.
Membandingkan hasil i3-1220P kami dengan laporan komunitas llama-bench lainnya memperlihatkan bahwa kemenangan iGPU pada tg sangat bergantung pada susunan inti CPU vs jumlah Execution Unit (EU) iGPU, di samping peningkatan shader pada ggml-vulkan dan Mesa 25 terkini:
| Perangkat / Arsitektur | Susunan CPU vs iGPU | Perubahan pp (iGPU) |
Perubahan tg (iGPU) |
Sumber / Konteks |
|---|---|---|---|---|
| Intel N150 (Twin Lake) | 4 E-core vs 24 EU | +220% (8.0 → 25.6 t/s) | -33% (4.0 → 2.66 t/s) | Uji Vulkan komunitas (r/LocalLLaMA); 24 EU terlalu lemah untuk mengalahkan 4 E-core pada decode |
| Intel i3-1220P (Uji coba ini) | 2 P + 8 E-core vs 64 EU | +24% s/d +26% | +25% s/d +45% | Uji coba b11564 kami; 2 P-core + E-core tersendat sebelum RAM mentok; 64 EU melesat lebih cepat |
| Ryzen 5 5600H (Cezanne) | 6 Zen 3 core vs Vega 7 (7 CU) | +123% (34 → 76 t/s) | ~0% (Imbang) (~10 t/s) | Laporan llama-bench TechHara; 6 P-core penuh sudah menjenuhkan bandwidth DDR4 |
Poin Penting:
- Pada APU dengan 6 hingga 8 P-core simetris (seperti Ryzen 5 5600H), inti CPU saja sudah sanggup menjenuhkan bandwidth memori sistem saat proses decode token tunggal, sehingga generasi token berakhir imbang.
- Pada chip kelas hemat dengan 24 EU (seperti Intel N150), unit eksekusi GPU terlalu terbatas untuk melampaui 4 E-core pada kalkulasi decode.
- Pada laptop Intel hybrid dengan hanya 2 P-core dan 64 EU (seperti i3-1220P kami), pembagian thread antar inti P dan E menjadi pembatas utama jauh sebelum batas bandwidth RAM tercapai, memungkinkan iGPU Alder Lake 64 EU unggul nyata pada tahap prefill maupun generasi token.
Panduan Menguji Sendiri di Laptopmu
Ingin menguji apakah iGPU laptopmu juga menghasilkan token rate yang lebih baik dibanding CPU? Berikut langkah-langkah praktisnya.
Langkah 1: Pasang Driver Vulkan & Tool Monitoring
Di Linux Mint, Ubuntu, atau Debian, buka terminal dan jalankan:
# Pasang paket vulkan dan tool monitor GPU intel
sudo apt update
sudo apt install vulkan-tools mesa-vulkan-drivers intel-gpu-tools -y

# Pastikan driver Vulkan mendeteksi GPU Intel kamu
vulkaninfo --summary
Pastikan perangkat Intel iGPU kamu muncul di daftar Devices dengan dukungan VULKAN_VERSION_1_3 atau lebih baru.
Langkah 2: Unduh Binary llama.cpp Siap Pakai (Vulkan)
Kamu bisa langsung mengunduh binary rilis resmi:
# Buat folder kerja
mkdir -p ~/src/llama-bench-test && cd ~/src/llama-bench-test

# Unduh prebuilt release dengan dukungan Vulkan
# Cek tag terbaru di https://github.com/ggerganov/llama.cpp/releases
wget https://github.com/ggerganov/llama.cpp/releases/download/b11564/llama-b11564-bin-ubuntu-x64.zip
unzip llama-b11564-bin-ubuntu-x64.zip
chmod +x ./build/bin/llama-bench ./build/bin/llama-cli
(Catatan: Jika mengompilasi dari source code dengan cmake, gunakan argumen -DGGML_VULKAN=ON.)
Langkah 3: Unduh Model GGUF untuk Pengujian
# Contoh mengunduh MiniCPM 2B (Q4_K_M)
wget https://huggingface.co/openbmb/MiniCPM5-2B-GGUF/resolve/main/MiniCPM5-2B-Q4_K_M.gguf
Langkah 4: Jalankan Uji A/B
Gunakan utility llama-bench untuk mengukur kecepatan pemrosesan tanpa overhead UI atau server HTTP.
Parameter yang digunakan:
-p 128: 128 token prompt-n 256: 256 token generasi jawaban-r 3: 3 kali pengulangan untuk nilai rata-rata-t 8: 8 thread CPU
Tes A: CPU Saja (-ngl 0)
./build/bin/llama-bench \
  -m MiniCPM5-2B-Q4_K_M.gguf \
  -p 128 -n 256 -r 3 -t 8 \
  -ngl 0
Tes B: Offload Penuh ke iGPU (-ngl 99)
./build/bin/llama-bench \
  -m MiniCPM5-2B-Q4_K_M.gguf \
  -p 128 -n 256 -r 3 -t 8 \
  -ngl 99
(Beri jeda pendinginan sekitar 20 detik di antara kedua tes agar suhu prosesor stabil.)
Langkah 5: Pantau Aktivitas GPU Secara Real-Time
Buka jendela terminal baru, lalu jalankan:
sudo intel_gpu_topSaat Tes B berjalan, perhatikan grafik bar Render/3D yang langsung aktif di kisaran 85% - 98%, sementara beban CPU tetap rendah.
Catatan Praktis: Kapan CPU Masih Relevan?
Meskipun iGPU lebih kencang, CPU tetap berguna pada skenario tertentu:
- Batas Daya Paket (Package TDP): Pada laptop tipis, CPU dan iGPU berbagi satu batas daya yang sama (15W hingga 28W). Jika menjalankan generasi dokumen panjang tanpa henti, panas yang terakumulasi bisa memicu penurunan clockspeed.
- GPU Sedang Menangani Tampilan Berat: Jika kamu sedang menyambungkan monitor eksternal ganda atau memutar video beresolusi tinggi, membiarkan tugas LLM di CPU (
-ngl 0) menjaga antarmuka desktop tetap responsif tanpa stutter.
Kesimpulan
Teori awal menyebutkan bahwa iGPU dengan RAM bersama tidak akan bisa mengungguli CPU. Namun pada praktiknya, driver Vulkan modern, zero-copy UMA, dan unit eksekusi GPU yang homogen berhasil melewati hambatan sinkronisasi thread pada CPU hybrid, memberikan peningkatan performa nyata sebesar 25% hingga 45% di laptop kelas entry-level.