Panduan Self-Hosting AI Lokal di Laptop Celeron N4100: Langkah demi Langkah
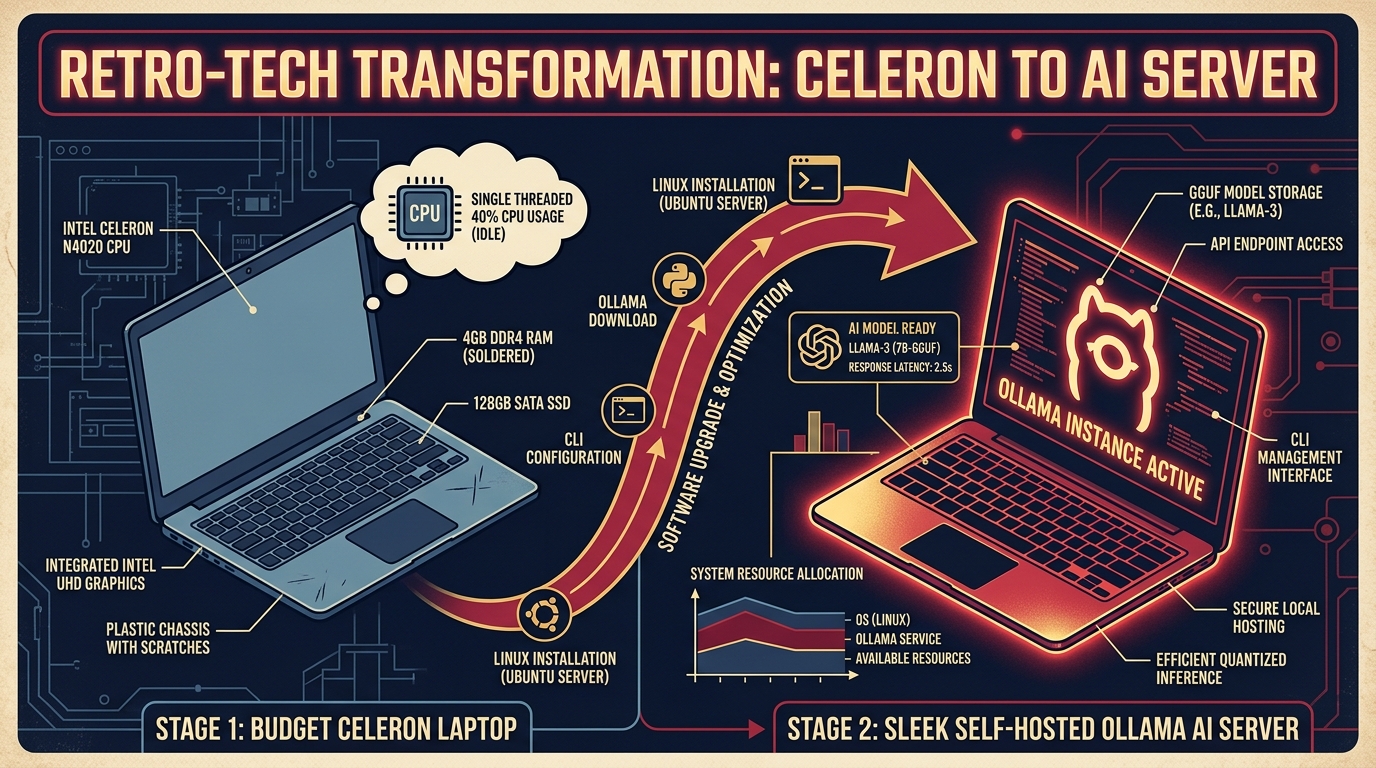
Premis: Anda memiliki laptop bekas yang tersimpan di lemari — Intel Celeron N4100 dengan RAM 8 GB. Anda ingin mengubahnya menjadi server AI pribadi menggunakan Ollama.
Apakah ini terdengar tidak biasa? Tentu. Namun apakah ini benar-benar bisa bekerja? Jawabannya: Ya, sangat bisa.
Pada Bagian I, saya menjelaskan alasan kendala hardware ini dan bagaimana trik RAG mampu memangkas waktu jeda prompt dari 120 detik menjadi di bawah 1 detik. Kali ini, kita akan membahas langkah teknisnya: cara mengonfigurasi laptop Celeron 6-Watt (bw-n4100) menjadi server Ollama headless yang dapat diakses secara lokal.
Spesifikasi Hardware yang Digunakan
Sebelum memulai konfigurasi terminal, mari kita lihat spesifikasi perangkat yang digunakan:
- CPU: Intel Celeron N4100 — 4 core, 4 thread, 1.10 GHz base / 2.40 GHz burst
- GPU: Integrated Intel UHD Graphics 600 — 0 MB VRAM terdedikasi
- RAM: 8 GB DDR4, single-channel
- TDP: 6 Watt — konsumsi daya lebih rendah dari bohlam lampu LED standar
- Instruksi Khusus: Tanpa AVX2 SIMD
Menjalankan AI di perangkat ini membutuhkan pemilihan model yang tepat serta konfigurasi systemd yang optimal.
Langkah 1: Install Ollama
Proses instalasi Ollama pada Linux sangat sederhana. Buka terminal pada laptop Celeron Anda dan jalankan skrip resmi:
curl -fsSL https://ollama.com/install.sh | shSkrip ini akan mengunduh binary Linux, membuat user layanan ollama, dan mendaftarkannya ke systemd secara otomatis.
Verifikasi instalasi dengan perintah:
ollama --versionLangkah 2: Mengatur Layanan Background dengan systemd
Agar Ollama berjalan otomatis sebagai server headless tanpa perlu membuka jendela terminal terus-menerus:
Periksa status layanan:
sudo systemctl status ollamaPastikan status menunjukkan active (running).
Untuk menghentikan atau merestart layanan:
sudo systemctl restart ollama
sudo systemctl stop ollama
Langkah 3: Membuka Akses Jaringan Lokal
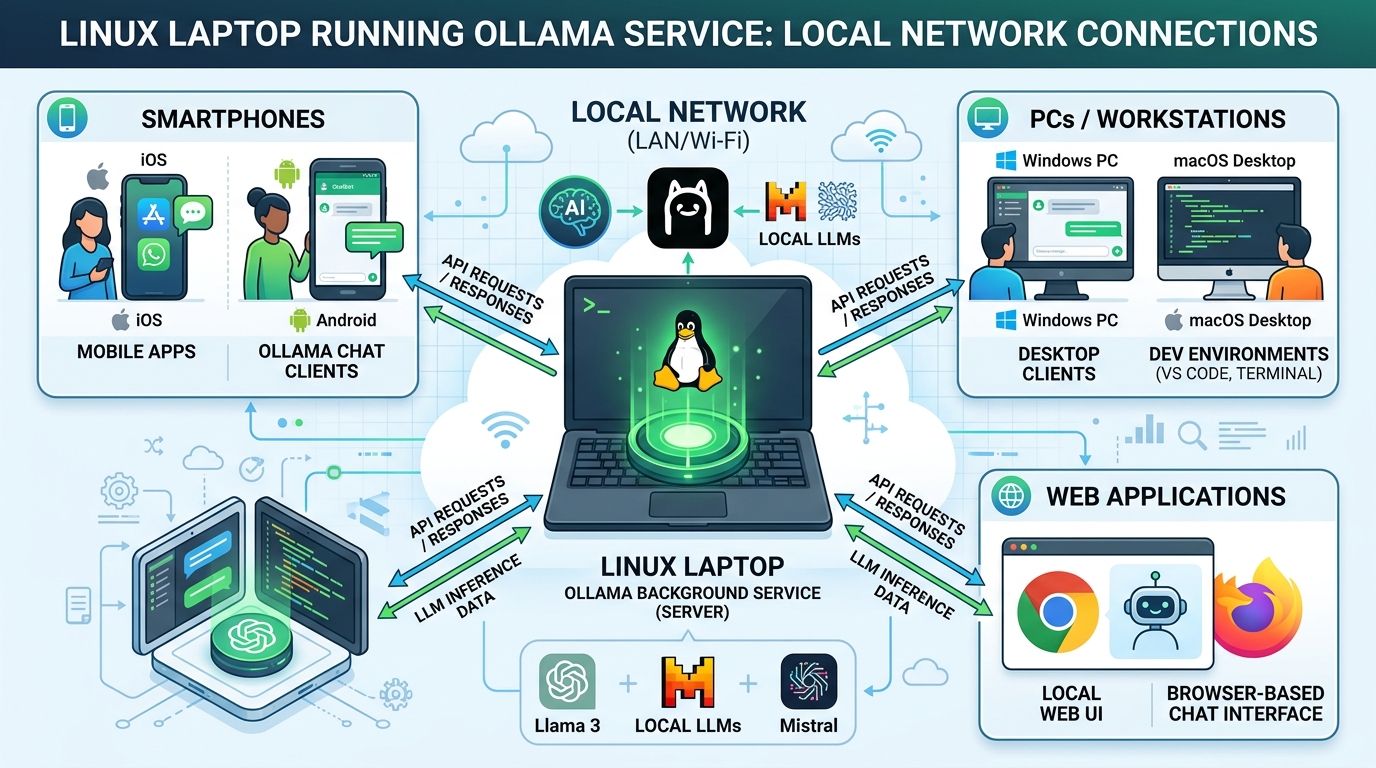
Secara default, Ollama hanya mendengarkan pada IP lokal 127.0.0.1:11434. Agar server ini dapat diakses dari PC utama, smartphone, atau aplikasi web di jaringan Wi-Fi/Tailscale Anda, ubah konfigurasi bind address:
- Edit konfigurasi layanan:
sudo systemctl edit ollama.service- Tambahkan baris berikut di bawah blok
[Service]:
[Service]
Environment="OLLAMA_HOST=0.0.0.0:11434"- Simpan dan muat ulang
systemd:
sudo systemctl daemon-reload
sudo systemctl restart ollama
Kini endpoint API Ollama telah aktif dan dapat diakses dari perangkat lain dalam jaringan lokal Anda.
Langkah 4: Memilih Model yang Sesuai dengan CPU 6-Watt
Menjalankan model 70B pada spesifikasi ini tidak memungkinkan. Agar respons tetap cepat dan stabil, pilih model terkuantisasi kecil di bawah 2 miliar parameter (2B).
Rekomendasi Model untuk Celeron N4100 + RAM 8 GB:
| Model | Perintah | Penggunaan RAM | Kecepatan Rata-rata | Kegunaan Terbaik |
|---|---|---|---|---|
| Qwen 2.5 0.5B | ollama pull qwen2.5:0.5b |
~350 MB | 3.5–4.0 token/detik | RAG, Tanya Jawab Cepat, Pencarian |
| Qwen 2.5 1.5B | ollama pull qwen2.5:1.5b |
~1.1 GB | 1.8–2.2 token/detik | Analisis Kode, Pemikiran Terstruktur |
| Llama 3.2 1B | ollama pull llama3.2:1b |
~800 MB | 2.5–3.0 token/detik | Percakapan Umum |
Unduh model pertama Anda:
ollama pull qwen2.5:0.5bUji coba melalui terminal:
ollama run qwen2.5:0.5b "Hello! Confirm you are running on a 6-Watt Celeron laptop."Langkah 5: Optimasi Kinerja
Beberapa penyesuaian konfigurasi dapat meningkatkan performa secara signifikan:
Pengaturan Environment Ollama
sudo systemctl edit ollama.service[Service]
Environment="OLLAMA_HOST=0.0.0.0:11434"
Environment="OLLAMA_ORIGINS=*"
Environment="OLLAMA_NUM_THREADS=4"
Environment="OLLAMA_MAX_LOADED_MODELS=2"
Environment="OLLAMA_KEEP_ALIVE=-1"Pengaturan OLLAMA_KEEP_ALIVE=-1 mencegah model di-unload dari RAM secara otomatis setelah 5 menit idle, sehingga permintaan berikutnya tidak perlu menunggu proses pemuatan ulang.
Terapkan perubahan:
sudo systemctl daemon-reload
sudo systemctl restart ollama
Membuat Variasi Modelfile Khusus
Buat konfigurasi model yang membatasi konteks agar respons tetap ringan:
cat << 'EOF' > Modelfile.qwen
FROM qwen2.5:0.5b
PARAMETER num_ctx 1024
PARAMETER num_predict 128
PARAMETER num_keep 24
PARAMETER temperature 0.5
EOF

ollama create qwen2.5-fast -f Modelfile.qwen
rm Modelfile.qwen
Pre-load Model Saat Startup
Jalankan perintah ini setelah restart agar model langsung dimuat ke RAM:
curl -s http://127.0.0.1:11434/api/generate -d '{"model": "qwen2.5-fast:latest", "keep_alive": -1}' > /dev/nullLangkah 6: Pengujian API dan Pemantauan Log
Server Celeron Anda kini menyediakan REST API yang kompatibel dengan format OpenAI.
Uji Coba Permintaan via cURL:
curl http://<ip-laptop-anda>:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen2.5-fast:latest",
    "messages": [
      {"role": "user", "content": "Explain what a CPU cache is in two short sentences."}
    ],
    "stream": false
  }'
Memantau Log Eksekusi:
journalctl -u ollama -fPerhatikan dua baris metrik utama pada log:
prompt eval time = 230.65 ms / 1 tokens     (waktu jeda awal)
eval time        = 40079.61 ms / 144 tokens (kecepatan generasi: ~3.59 token/detik)
Kesimpulan
Menjalankan server AI di laptop Celeron N4100 dengan RAM 8 GB terbukti dapat diandalkan jika dipadukan dengan model 0.5B, prefix caching, dan pipeline RAG yang efisien. Setup ini mampu memberikan respons di bawah 1 detik dengan kecepatan 3.5+ token/detik pada konsumsi daya yang sangat rendah.
- Bagian I: Dari 120 Detik Menjadi Kurang dari 1 Detik
- Bagian II: Membangun Server AI Sendiri (Anda di sini)
- Bagian III: Membangun AI Chatbot untuk Grav CMS