Cepat, Lokal, dan Hemat Daya: Mengintegrasikan AI Chatbot ke Dalam Grav CMS
Pada artikel sebelumnya, Self-Hosting AI Lokal di Laptop Celeron N4100, saya membuktikan bahwa laptop Celeron 6-Watt hemat daya dengan RAM 8 GB mampu menjalankan Ollama dan memproses model ringan seperti Qwen2.5 (0.5B).
Pertanyaan selanjutnya adalah: dapatkah mesin ini berfungsi sebagai chatbot dokumentasi interaktif untuk situs web — tanpa membebani CPU atau membuat pengunjung menunggu hingga 120 detik?
Jawabannya adalah ya — dan dalam prosesnya, skrip pencarian sederhana ini berkembang menjadi plugin utuh. Berikut adalah penjelasan teknis bagaimana grav-ai-chatbot bekerja.
Tantangan: RAM 8 GB dan Tanpa AVX2
Sebagian besar sistem pencarian AI (Retrieval-Augmented Generation / RAG) mengandalkan vector database seperti ChromaDB atau Qdrant yang membutuhkan pemrosesan model embedding terpisah di memori.
Pada Intel Celeron N4100, pendekatan tersebut menghadapi kendala:
- Keterbatasan RAM. Menjalankan LLM sekaligus model embedding secara bersamaan menyisakan sedikit memori untuk sistem.
- Ketiadaan AVX2. Operasi vektor tanpa instruksi AVX2 menyebabkan beban tinggi pada CPU — meningkatkan jeda prompt menjadi 30–45 detik per pertanyaan.
Oleh karena itu, prinsip utamanya adalah: hanya kirimkan pertanyaan ke model AI jika memang diperlukan, dan hindari kalkulasi berulang pada CPU.
Arsitektur Pipeline 5 Tingkat
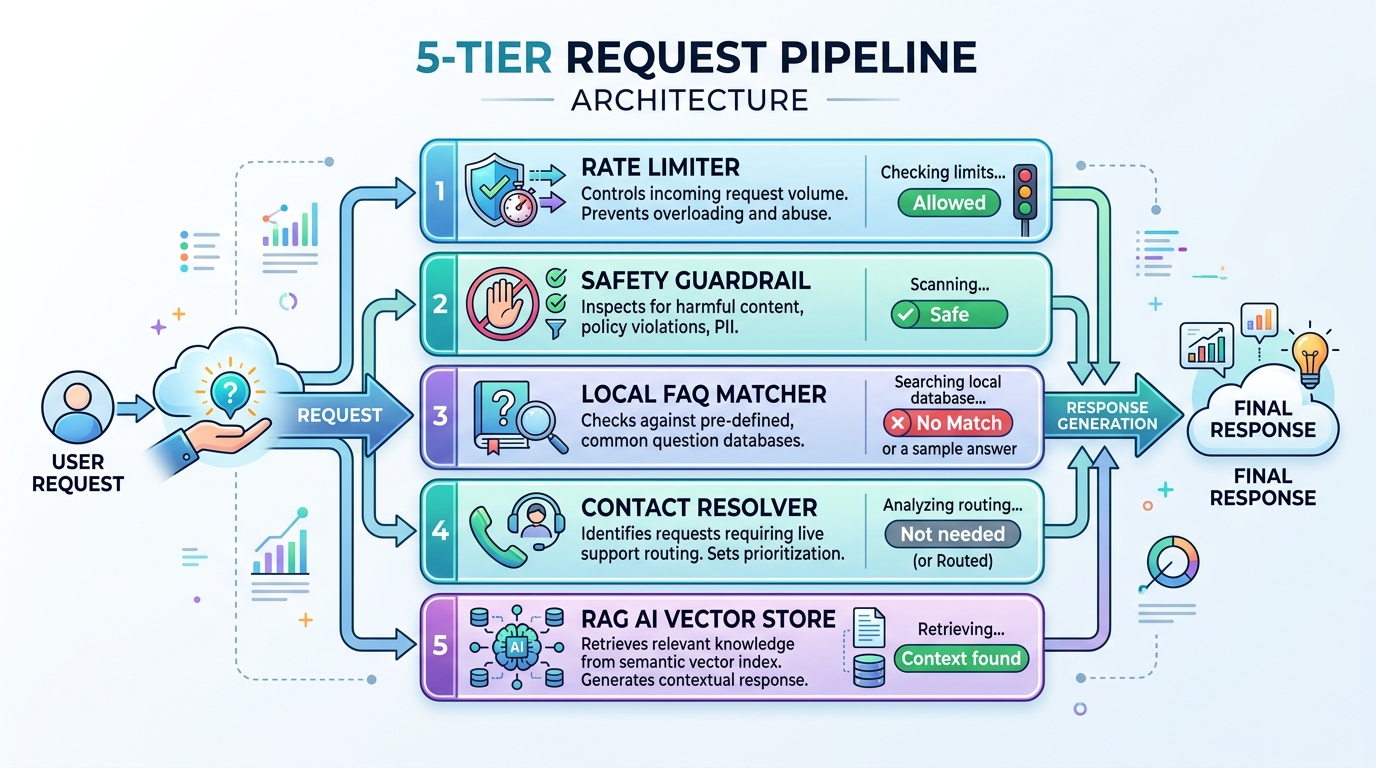
Setiap pesan dari pengunjung diproses melalui pipeline 5 tingkat, di mana permintaan baru diteruskan ke model AI jika tidak dapat diselesaikan oleh tingkatan sebelumnya:
Pengunjung mengajukan pertanyaan
        │
        ▼
Tingkat -1 — Rate Limiter       → batas permintaan terlampaui? → blokir, HTTP 429
        │ (lolos)
        ▼
Tingkat 0 — Safety Guardrail    → kata terlarang terdeteksi? → blokir lokal, 0 token
        │ (lolos)
        ▼
Tingkat 1 — Match FAQ Lokal     → cocok dengan FAQ? → jawaban instan, 0 token
        │ (tidak cocok)
        ▼
Tingkat 2 — Contact Resolver    → pertanyaan kontak/support? → info kontak lokal, 0 token
        │ (tidak cocok)
        ▼
Tingkat 3 — RAG Retrieval       → cari vector store SQLite, ambil potongan relevan
        │
        ▼
Tingkat 4 — AI Completion       → kirim pertanyaan + potongan ke Gemini / Groq / OpenAI / Ollama
        │
        ▼
Telemetry Logger                → catat penggunaan token, biaya, dan tingkat yang merespons
Empat dari lima tingkatan di atas tidak menggunakan API AI sama sekali. Pada prosesor Celeron, hal ini sangat menghemat sumber daya sistem.
Mengapa Membangun Engine RAG Sendiri Dibandingkan Menggunakan TNTSearch Default Grav?
Pertanyaan yang sering muncul adalah: Mengapa membuat engine RAG sendiri padahal Grav sudah memiliki plugin pencarian TNTSearch?
Meskipun TNTSearch sangat baik untuk pencarian kata kunci situs, ada tiga alasan teknis mengapa RAG kustom diperlukan untuk LLM:
- Potongan Berbasis Header vs Halaman Utuh (
Chunker.php):
TNTSearch mengindeks seluruh halaman sebagai satu dokumen utuh. Mengirimkan halaman 2.000 kata untuk menjawab pertanyaan singkat akan membuang banyak token prompt. Engine RAG kustom membagi halaman menjadi potongan 150–300 kata berdasarkan header# H1,## H2, dan### H3. - Pencarian Vektor Semantik vs Kata Kunci (
VectorStore.php):
TNTSearch menggunakan pencarian kata kunci BM25. Jika pengunjung bertanya "Kapan kantor buka?" tetapi halaman menggunakan judul "Jam Operasional", pencarian kata kunci biasa bisa luput. Engine RAG kustom mendukung embedding vektor (Ollamanomic-embed-text, Geminitext-embedding-004, OpenAI, dan TF-IDF lokal) dengan cosine similarity. - Anchor Link Langsung ke Bagian Halaman:
TNTSearch hanya memberikan URL halaman utama. Engine RAG kustom melampirkan anchor header (contoh:/docs/install#prerequisites) sehingga AI dapat memberikan tautan referensi yang presisi.
Manajemen Indeks Konten Auto-Sync
Engine RAG menjaga kebaruan indeks melalui alur berikut:
Halaman Grav (dipublikasi) → bersihkan HTML/CSS → bagi per header → cek hash SHA-256 → simpan ke SQLite- Chunking Berbasis Header (
Chunker.php): Membagi halaman berdasarkan header Markdown dan memberikan tag rute serta anchor link. - Hash Caching Incremental (
Indexer.php): Memeriksa hash SHA-256 tiap bagian sebelum melakukan re-embedding. Bagian yang tidak berubah akan dilewati. - Penyimpanan Vektor SQLite (
VectorStore.php): Potongan teks, metadata, dan vektor disimpan dalam satu filerag_index.sqlitedengan waktu pencarian di bawah 1 milidetik.
Plugin ini secara otomatis memperbarui indeks saat ada perubahan halaman melalui event onPageSaved dan onPageDeleted, serta mendukung scheduled job (ai-chatbot-rag-reindex) via scheduler bawaan Grav.
Telemetry dan Analisis
Setiap interaksi dicatat ke user/data/ai-chatbot/interactions.json untuk merekam penggunaan token, biaya, serta tingkatan yang memberikan jawaban. Dashboard admin menampilkan grafik distribusi pertanyaan serta merekomendasikan calon entri FAQ baru berdasarkan pertanyaan yang sering mencapai tingkat AI.
Cara Instalasi di Grav CMS
Plugin ini bersifat open source dan tersedia di GitHub:
👉 github.com/milkboyinchina/grav-ai-chatbot
Persyaratan
- Situs Grav CMS yang berjalan.
- Ollama lokal (jika menggunakan model lokal) atau API Key (Gemini, Groq, OpenAI, OpenRouter).
Langkah Instalasi
cd /var/www/html/grav/user/plugins
git clone https://github.com/milkboyinchina/grav-ai-chatbot.git ai-chatbot
Membuat Indeks Awal
cd /var/www/html/grav
php bin/plugin ai-chatbot index-rag --rebuild
Analisis Efisiensi Prompt: RAG vs Tanpa RAG
| Metrik | Tanpa RAG (Kirim Seluruh Situs) | Dengan RAG (Potongan Relevan) | Efisiensi |
|---|---|---|---|
| Strategi Konteks | Menggabungkan seluruh halaman | 2–3 potongan relevan via SQLite | 82% lebih kecil |
| Ukuran Prompt per Query | 204+ token (terus bertambah) | 36 token (stabil) | Hemat 168 token per query |
| Waktu Pencarian Lokal | 0.006 ms | 0.312 ms | Di bawah 1 milidetik |
| Kualitas Jawaban | Berpotensi mengalami halusinasi | Terangkar pada sumber data | Lebih akurat |
| Biaya API Estimasi (10.000 Query) | $0.31 | $0.05 | 82% lebih hemat |
Kesimpulan
Penggunaan struktur flat-file Grav, SQLite vector store, dan pipeline filter berlapis memungkinkan hardware terbatas seperti Celeron N4100 menyajikan layanan AI Chatbot secara responsif, efisien, dan hemat daya.
Silakan unduh dan coba pada situs Grav Anda:
🔗 GitHub: github.com/milkboyinchina/grav-ai-chatbot
- Bagian I: Dari 120 Detik Menjadi Kurang dari 1 Detik
- Bagian II: Membangun Server AI Sendiri
- Bagian III: Membangun AI Chatbot untuk Grav CMS (Anda di sini)