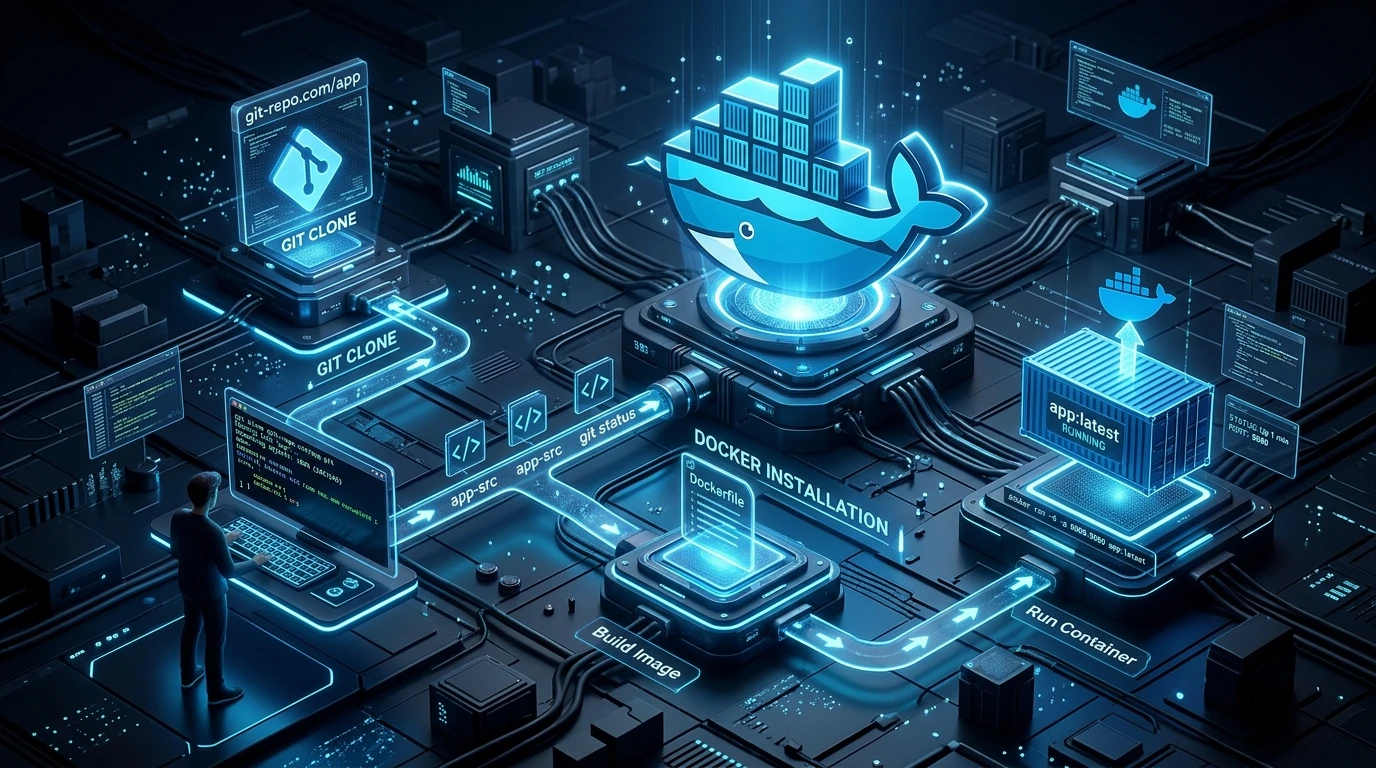
Panduan langkah demi langkah untuk menyiapkan dan mengintegrasikan Grav CMS menggunakan docker-lamp-grav di VPS Linux, macOS, dan Windows.
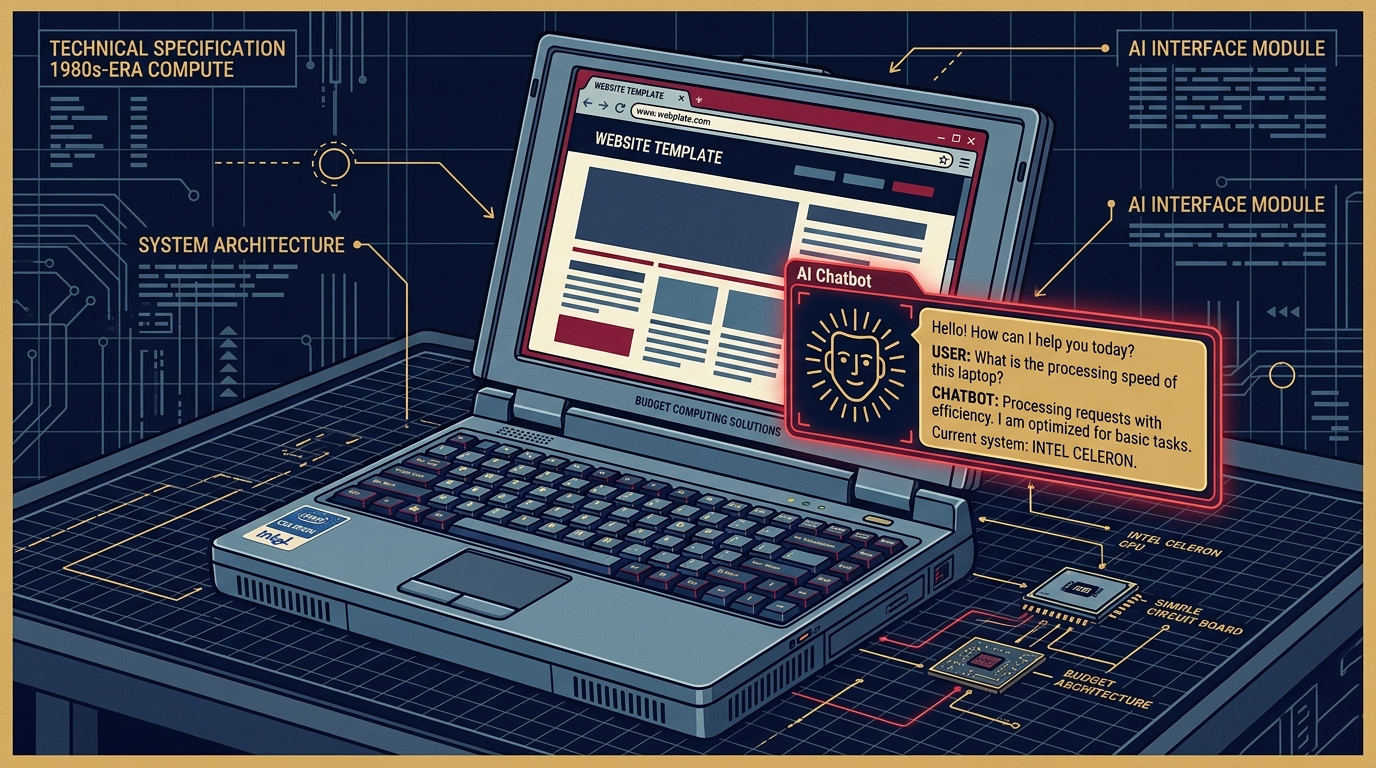
Dalam Bagian IV dari seri ini, kami melakukan benchmark terhadap latensi LAN lokal dan mesh Tailscale untuk grav-ai-chatbot, membuktikan bahwa transport jaringan sangat cepat dan andal. Namun, segera setelah model pemrosesan logika seperti qwen3.5:2b di-deploy ke produksi, pengguna mulai...
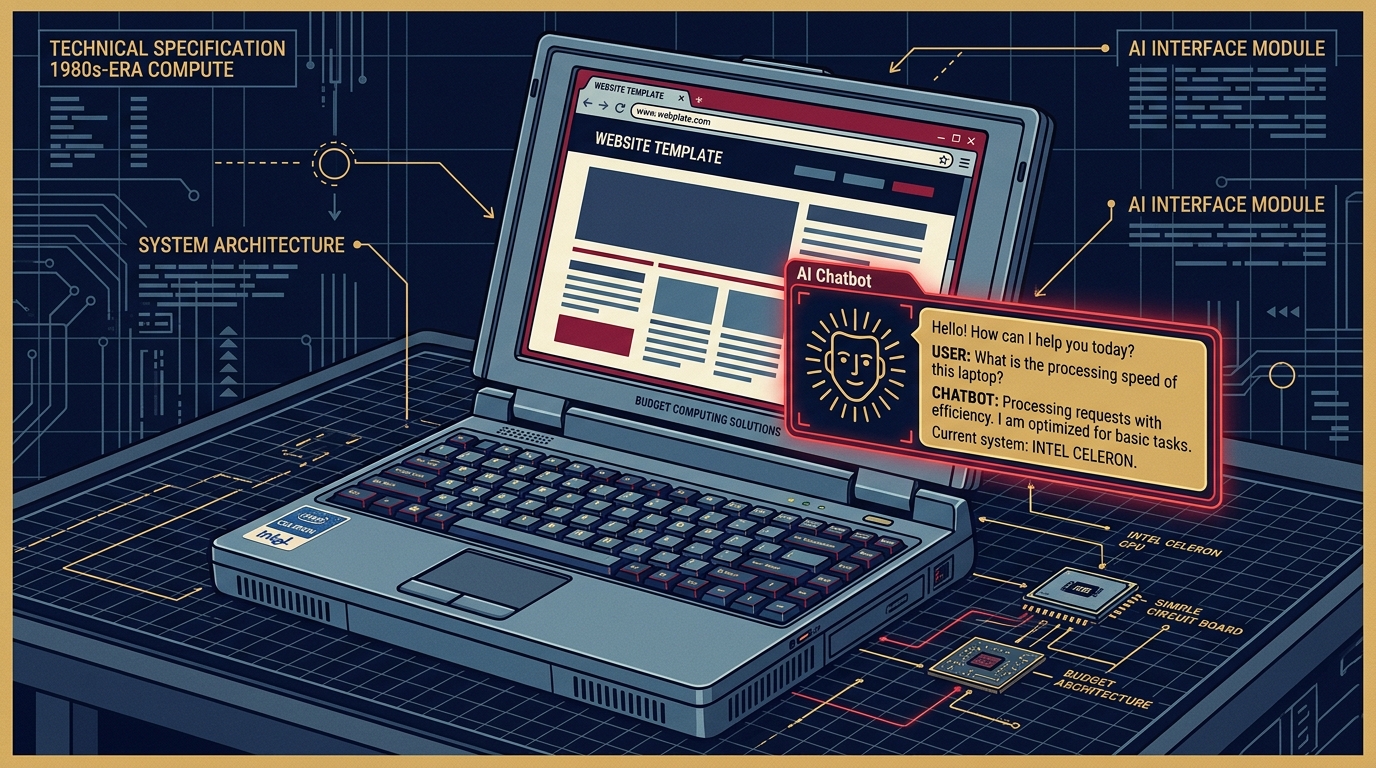
Pengujian Kinerja Ollama Melalui Tailscale & LAN: Mengejar Latensi di Bawah Detik untuk Chatbot Grav AI Di Bagian III, kami membangun pipeline 5 tingkat untuk grav-ai-chatbot — mesin pencari AI lokal yang berjalan di laptop Intel Celeron 6-Watt. Begitu chatbot itu mulai menerima lalu li...
Cepat, Lokal, dan Hemat Daya: Mengintegrasikan AI Chatbot ke Dalam Grav CMS Pada artikel sebelumnya, Self-Hosting AI Lokal di Laptop Celeron N4100, saya membuktikan bahwa laptop Celeron 6-Watt hemat daya dengan RAM 8 GB mampu menjalankan Ollama dan memproses model ringan seperti Qwen2.5 ...
Ollama di Intel Celeron, Bagian I: Memaksimalkan LLM Lokal dari Laptop Murah Bayangkan setup "AI lokal" yang sering dibicarakan orang: PC gaming dengan GPU NVIDIA gemerlap yang harganya lebih mahal dari mobil bekas. Sekarang bayangkan kebalikannya — sebuah mini PC Intel Celeron N4100 dengan...
Panduan mendalam tentang merancang lingkungan pengembangan Docker yang ringan dan andal untuk Grav CMS, PHP 8.3, Apache 2.4, dan infrastruktur server Linux modern.